
 最新跨境运营干货
 看多维度榜单信息
这一问问的是按什么顺序动手
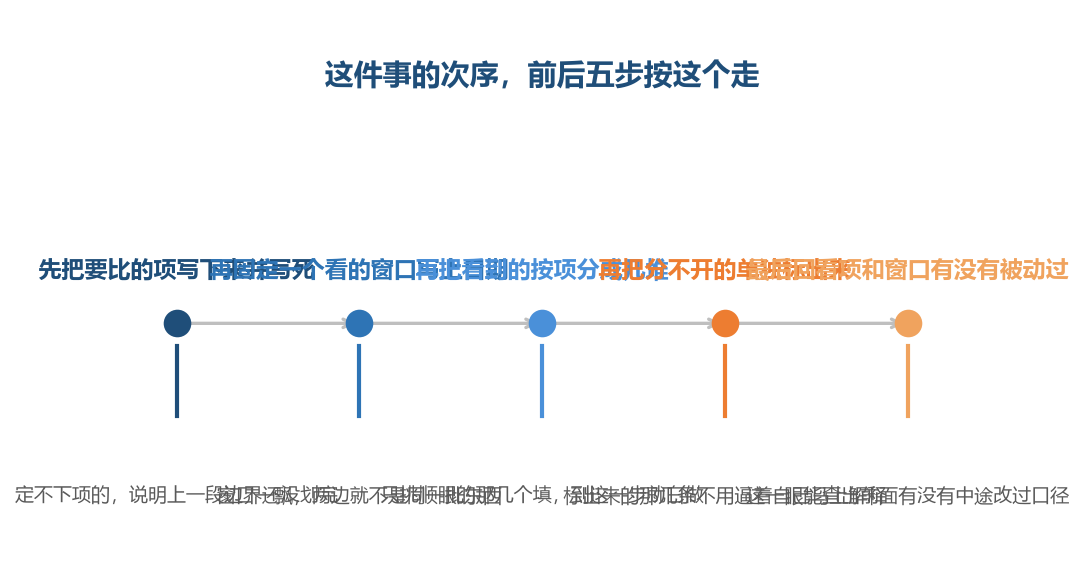
这四步的前后关系是死的,越过的每一步都会在后面的步骤里返工
这一句问的重点落在顺序两个字上。它不问要做哪些事,那些事已经清楚了;它问的是这些事按什么次序落下去。次序这件事的特别之处在于,它是单向的,前一步定下来的东西,后面几步都得照着走。
拿一个具体的场面来说。你手上有两个款,一款是你自己的,一款是对面挨着你的那一个。你打算看它们身上的评价数、上新日期和标题里反复出现的词。这三样里面先看哪一样、后看哪一样,看起来无关紧要,实际上会决定你后面能不能把看到的东西归成一类。
次序不能随便调的原因,是每一步都在给下一步缩小范围。第一步定下来要比什么,第二步才有东西可以限定在哪一段时间里看,第三步才能把看到的按项分开,第四步才能把分不开的那几样单独拎出来。次序一乱,缩范围这个动作就断了。
一个常见的误解是把这几步当成可以并行的几件事。同时做当然快,前提是它们互不影响。可这几步偏偏是互相影响的:你后面看到的每一处,都要挂在前一步定下的那一项上。并行做,等于每一处都要同时照顾好几个项。
还有一种误解是觉得次序写下来太多余,做过一遍自然就记住了。做过一遍确实能记住一个大概,问题是在换了类目、换了站之后,你记住的那个大概往往需要重新排。写下四步的意义,是让你每次换场景的时候有一个能重新对着走的东西。
这一句问的产出是一条能照着走的路,不是一份要收的东西。它不告诉你收什么,那不归它管;它也不告诉你收到的数怎么看,那也不归它管。它只管四步谁先谁后,以及每一步在什么位置可以停下来。
顺序这件事还有一个容易被忽略的性质,就是它不要求每一步都做到很细。第一步定下要比的项,定到能往下走就够了,不必把所有可能的项都想全。想全这一步花的力气,通常和它带来的好处不成比例,而它耽误的时间却要让后面三步一起等。
判断一条次序是不是站得住,看它能不能被复述。你把四步念给同事听,他能说出每一步在做什么,这条次序就是清的。他听完问了一句先做哪个,说明你的四步里有两步讲的是同一件事,或者有一步被漏掉了。
有人会问这四步能不能少一步。能少,少掉的代价在别处。少掉第一步,后面三步都在没有统一口径的情况下做,看到的东西彼此对不上;少掉第四步,你手上会留下一堆分不开的东西,它们既不能归到前面三类里,也不能直接扔掉。
也有人问这四步能不能再多加几步。能加,加的时候要分清哪些是动作,哪些是动作里的细节。比如把第一步拆成先看评价数再看上新日期,那已经不是新的步,而是第一步内部的次序。步数一旦涨到七八步,你在走的时候就会开始记不住。
这一句问的答案不因类目而改变,也不因站点而改变。同一个类目、不同的站,走的次序是一样的,变的只是每一步里你看的具体东西。次序作为一层框架,它的用处就是在这种换场景的时候还能继续用。
有一处很实际的差别要提前说清。这四步只覆盖到把看不懂的东西拎出来这一步,拎出来之后你要怎么处理,这一篇不管你。处理那一部分涉及判断,判断属于另外一句问。把处理混进来,这一篇就会变成另一篇。
有一种做法是先在心里把四步过一遍再坐下动手,这一步花不掉多少时间,却能挡掉大半的来回。心里过一遍的时候,最容易卡住的地方是第一句和第三句之间的关系:比什么还没定,你怎么知道要分成几堆。这一卡住,就说明次序是对的。
还有人问次序能不能按自己的习惯改一改。习惯这个东西在这一层里帮不上忙,因为四步之间的关系不是偏好,是依赖。你可以决定每一步花多久,可以决定在哪一步多看两眼,但你不能让第三步的输入来自第四步,那条线是接不上的。
如果四步走完之后你觉得手上还是空的,先别怀疑次序,先回头看第二步。第二步定的窗口太短或者太长,都会让后面三步看到的量不对。窗口太短,你分不出哪一堆是有规律哪一堆是偶然;窗口太长,你会发现什么都在动。
次序这一层最省事的地方,是它可以被完整地写在一张纸上,一共四行。写上之后你就不用每次重新想,只要对着走就行。多数人在同一件事上反复走偏,原因不是不会做,是每次都在临场重新决定次序。
第一步先把比的项定死
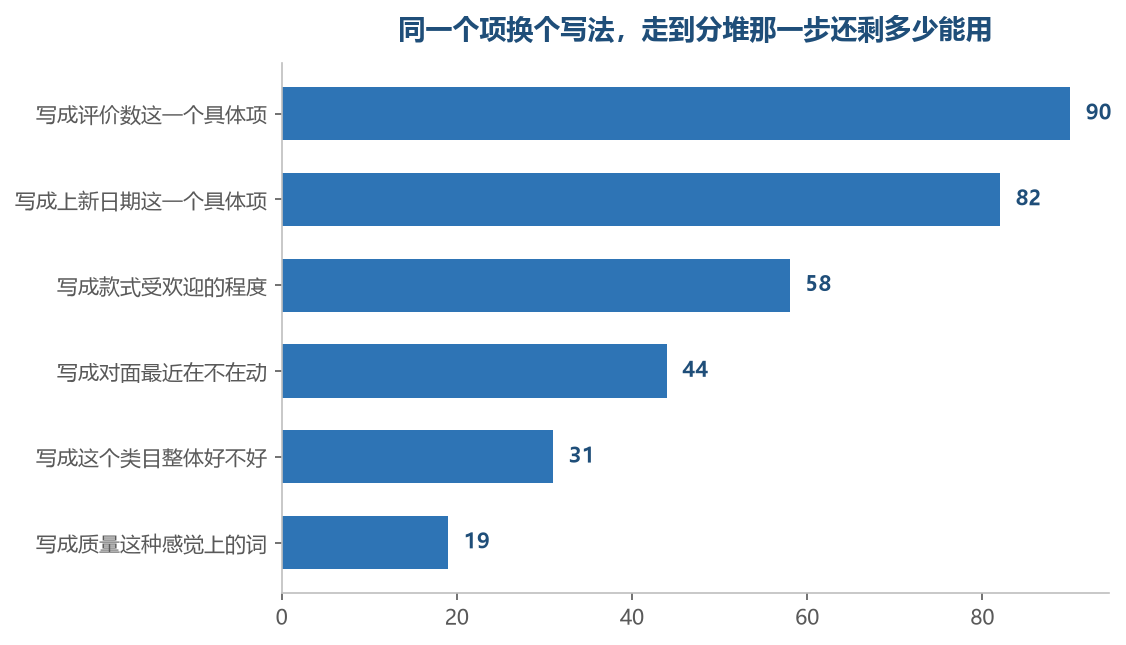
同一个项换个写法,走到分堆那一步还能剩下多少能用,差别就摆在这几行上
第一步要做的是把要比的项写下来,并且写死。写死的意思不是永远不改,是这一轮走到第二步之前不再改。项的数量通常控制在两项,最多三项。超过三项,后面第三步分堆的时候你会发现每一堆都同时属于好几类。
为什么要先定项,而不是先去看数。因为是先有项才有数,不是先有数再去找项。你先看数,会看到对面页面上有一堆东西,评价数、图、颜色、标价、上新日期都摆在那里。这时候你再说我要比评价数,其实已经是被看到的东西推着走了。
这一步具体怎么做。拿一张纸,左边写你这一款的名称,右边写对面那一款,中间那一列写你要比的项目,只写两行。写的时候不要去看页面,凭你现在最想问的那一句写。写完之后再打开页面,把这两项的数填进去。
停在哪算这一步做完。标志是你能一句话说出来要比什么,并且这句话里没有出现并且以外的东西。比如要比这两款在同一个档上的评价数,这是一句话。如果说成要比评价数还要比上新还要比主图,那已经不是一句话,是三步。
这一步要花的是什么。它花的是判断,几乎不花时间。你坐下来想十分钟,可能比翻两个小时页面更有用,因为它决定的是后面两个小时花在哪。多数人在这一步花的时间太少,把省下来的那几分钟交给了后面几步去还。
这一步最容易出的一种错,是把项定成了一个大类。比如把项写成质量、写成受欢迎程度,这种写法听着对,实际往里填不了数。项的写法要能对应到页面上一个能看见的东西,评价数能看见,质量看不见,这两者的差别在这一步就决定了后面能不能走。
另一种错是把项定成了对面的动作。比如把项写成对面在不在降价,这已经不是项,而是第二步之后才会出现的观察。项应该是两边都有的一个维度,不是你盯着对方的一举一动。写成动作之后,你就没法把你这一款摆到同一列上了。
还有一种错是把两边测不到同一项的也写进来。比如你想比两款的复购情况,这一项在公开那一层根本看不到,写上去等于给自己挖了个坑,走到第三步才发现这一列是空的。定项的时候顺手问一句,这一项我在这两边的页面上都能看到吗。
项定死之后还有一个直接的好处,就是你的记录有了列名。以后你翻出这张表,一眼就知道当初比的是什么。没有列名的记录过两周就变成一堆散落的数字,你自己都想不起当时为什么记这几样,只能整张扔掉重做。
如果把第一步挪到后面去,最先坏的就在这里。你先去翻页面,翻到的是几十项内容,然后你从里面挑出顺眼的几项来做项。挑的过程你看不见,你只会觉得自己是在总结,实际上你是在用看到的结果倒推要比什么。
这一倒推,后面的每一步都带着偏见走。第二步的窗口会不自觉地挑那些数据好看的时段;第三步的分堆会不自觉地按已有的判断来分;第四步拎出来的东西,往往就是你原本想不通的那几样,而不是真正分不开的那几样。
定项的时候还有一个细节,就是项的边界要写清。比如要比评价数,那要看的是总评价数还是最近一段的评价数,这两者不是一件事。写的时候把这一点也写上,第二步定窗口的时候就有了依据,不至于临场再决定。
写死的项在这一轮里是硬的,这跟随时可以改并不冲突。第一轮走完,你会发现某一项其实问不出东西,第二轮的项换成别的,这很正常。怕的不是改,是在一轮之内改,一轮之内一改,前面看到的那些就全部作废了。
定项这一步可以先把手边能看的那一层摊开,知虾的选品与关键词分析把同类目同层级公开能比的那几个数摆出来,更新到前一日,它手里没有你店铺后台里的成交那一段。摊开这一层之后,你要比的两项通常一眼就能挑出来,剩下的那几项不必再费劲去找。
定项这一步还有一个容易忽略的中间动作,就是把项写成一句能填数的问句。比如这一款和那一款,在同一个档上,各自积了多少条评价。写成问句之后你会发现,项里面其实还含着时间范围和层级范围,这两样要到第二步才定下来。
如果两项都写不出来,只剩一项能写,也不必强行凑。一项对照也能走完四步,只是后面分堆的时候堆数会少一堆。真正要避免的是为了凑两项,把一项原本问不出东西的硬塞进来,那会让第三步多出一堆永远空着的类别。
这一步做完之后不要急着填数,先把那两行念一遍。念得顺、听得懂,就往下走。念的时候自己都觉得别扭,多半是项写得太大或者写成了动作,这两种都得当场改掉,这时候改比后面改便宜得多。
第二步再固定一个看的窗口
| 四步 | 这一步做什么 | 停在哪算做完 | 把次序调换之后先坏在哪 | |||||||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 第 | 一 | 步 | ||||||||||||||||||
| 把 | 要 | 比 | 的 | 项 | 写 | 下 | 来 | 并 | 写 | 死 | , | 通 | 常 | 两 | 项 | |||||
| 能 | 一 | 句 | 话 | 说 | 出 | 要 | 比 | 什 | 么 | , | 句 | 子 | 里 | 没 | 有 | 并 | 且 | |||
| 先 | 翻 | 页 | 面 | 再 | 回 | 头 | 定 | 项 | , | 等 | 于 | 用 | 结 | 果 | 倒 | 推 | 要 | 比 | 什 | 么 |
第二步要做的是给这件事加一个时间范围,写清从哪一天看到哪一天,并且两边用同一个范围。窗口一固定,你看到的就不是一个静态的画面,而是这一段时间里发生的事。这一步花的是判断加一点手上的动作,通常十几分钟就能定下来。
窗户这个词在这里是比喻,实际写的是一行日期。这一行日期要写在记录的最上面,跟项的列名并排放。写在最上面的原因是,它管的是整张表,不是某一行。写在中间或者写在末尾,你下次翻的时候容易看不见。
窗口的长度怎么定,这一步不做规定,因为它属于判断标准,是另外一句问的事。这里只说一个可操作的做法:先把你打算看的这一段时间写下来,再看对面那一款在这个范围里有没有动过。动过的地方越多,说明这个窗口里能看到的差别越丰富。
停在哪算这一步做完。标志是两边的日期对得上,窗口长度一致。你这一边看的是从月初到月末,对面那一边也得是同一段,不能一边看一个月一边看三个月。长度不一致的时候,两边的数天然不可比,后面再怎么分堆都分不出东西。
这一步要花的是什么。它花的是核对的时间,手上的动作不多,就是写一行日期、再确认一遍对面的日期。这一步看似最轻,实际它挡掉的是最难发现的一种错,因为日期不对的时候,两边的数看上去都是齐的,只有那一行不对。
有一个常见的做法是跳过这一步直接去看。跳过之后你会看到一堆数,这些数单个看都对,摆到一起却读不出东西。这时候多数人会怀疑是项选错了,回去改项,改完还是不对。真正的原因在窗口,只是窗口那一行太不显眼,容易被忽略。
如果把第二步挪到第三步之后,最先坏在分堆上。你先按看到的东西分成几堆,堆分完了才回头去定窗口。这时候你会发现分出来的堆很不稳,因为它是在一个长度不确定的范围上分的,换一个窗口,同一件事可能落到另一堆里。
堆不稳的后果是你会反复重分。今天分出来是三类,过两天看一眼又觉得应该是两类。这不是你分得不好,是基准没定。基准就是窗口,窗口一飘,跟着飘的东西就不止堆,还有你前面记下来的那些动作。
窗口这一行还有一个用处,是把对照钉在一个共同的坐标上。两边共用一个范围,你看到的所有差别才有可能来自两边本身,而不是一个看了一个月、一个看了三个月的差别。这一步的价值就在这里,它让后面的对照站得住。
定窗口的时候有一件事要顺手做掉,就是把日期也写进每一条记录里。不是写在表头那一行,而是写在具体那一条的旁边。表头会变,具体那一条不会。隔一段时间回头看,靠的就是每一条旁边那个日期。
还有一个小提醒,窗口不要在走的过程中延长。你今天定了一个月,走到第三步的时候觉得不太够,顺手改成三个月。这一改,前面按一个月归好的东西就得全部重新看。想换窗口可以,等这一轮走完,下一轮换。
窗口还有一个作用在跨站比较的时候才显出来。同一个类目放在两个站上,活跃的时段不一样,你手上那一份数据是前一日的,对面那一站上能看到的数据也落在接近的日子上。两边日期差得太远,看到的结构差别里就分不清哪一部分来自站与站的不同。
窗口和项这两样是绑在一起的。项决定你看哪一列,窗口决定你看这一列的哪一段。两样都写下来之后,你手上就有了一张有列名、有时间范围的表。这张表是后面两步共同的落脚点,第三步分堆分的也正是它,少了它后面两步没有可以对着走的东西。
第三步再把看到的分堆
第三步要做的是把看到的东西按类分开,每一堆放一个名字。名字要具体,比如这一堆是两边差得最明显的,那一堆是两边几乎没差的,第三堆是看着有差但对不上项的。名字起得出来,说明你确实在分;起不出来,说明你还在看。
分堆的依据是项,不是感觉。你第一步定了几项,第三步就按这几项分。两项的对照,最自然的分布是三堆:一项上差别明显、另一项上差别明显、两项上都几乎没差。实际走的时候往往还会多出一堆,就是对不上项的那些。
停在哪算这一步做完。标志是每一处看到的东西都能落进某一堆里,没有一处悬空。有悬空的说明你的堆没分完,或者某一处其实同时属于两堆。同时属于两堆的那一类,正好是第四步要处理的,可以先记下来。
这一步要花的是什么。它花的是手上的动作,判断的成分比前面两步少。翻记录、抄进不同的地方、起名字,都是手上的活。时间上它比第一步和第二步都费,但费得比较踏实,因为你知道自己在做什么。
有一个很实用的做法是给每一堆配一个数量。第一堆有四处,第二堆有两处,第三堆有六处。数量一写上去,你就能看出这一轮看到的差别集中在哪一类上。这一步不评价哪一类要紧,只把分布摆出来。
起名字的时候要避开两种写法。一种是把堆名起成结论,比如这一堆是值得跟进的地方,这样名字本身已经带了判断,而判断不属于这一步。另一种是把堆名起得太虚,比如其他,其他这一堆会越滚越大,最后吃掉所有分类的意义。
如果把第三步挪到第二步之前,最先坏在堆的稳定性上。前面说过窗口没定,堆就会飘。还要补一句:先分堆再定窗口,你分堆的时候看到的量是不完整的,因为你不知道你要看的那一段时间到头了没有。在这种不完整的量上分出来的堆,参考价值很低。
分堆这一件事还有一个容易被忽略的好处,就是它能把你的注意力从个别现象上挪开。只盯着某一处看,你会觉得它特别重要。分成堆之后,你看到的是这一处属于哪一类,同类里还有几处。同类的数量本身就是一个可以参考的事实。
分堆的时候不要顺手删东西。看着没什么用的那一处,先放进某一堆或者放进悬空那一类,不要当场划掉。删这个动作在第三步做,很容易把解释别的几处的那一条一并删掉,而删掉之后你也不会知道自己删了什么。
分堆这一步还可以顺手回答一个问题:这一轮看到的差别够不够多。三堆加起来只有三四处的,说明两边确实很接近,这一轮的信息量本来就不大,不必硬往深里挖。三堆加起来十几处的,多半是你把不相干的东西也算进来了,回头看第一步的项。
知虾能站的位置是在公开那一层的结构上,它把类目怎么分、价位怎么分布、各个站之间差在哪儿摆出来,这些是分堆时可以先看的一层底。你店铺后台那一段它接不到,外站的数据也不会整批替你做汇总,分堆这一步仍然要靠你自己按项来分。
分堆分完之后,建议把三堆平铺在一张纸上,让它们互相看得见。堆与堆之间的关系有时候比堆内部更值得看,比如第一堆和第二堆恰好都在同一个项上,这就说明你第一步定的项可能太窄,两项其实说的是同一件事。
这一步还有一个操作上的细节,就是堆的顺序不按重要性排,按数量排。数量多的放前面,数量少的放后面,判断哪堆重要的活留给后面那一句问。这一步只需要一个整齐的分布,不需要一个带有倾向的分布。
如果最后分成六堆以上,说明第一步的项定多了,或者你把同一件事拆成了好几堆。堆数一多,你在走第四步的时候就没有精力逐堆处理。这时候的调整办法不是合并堆,而是回到第一步,把项减到两项再走一遍。
第四步把看不懂的单独标出来
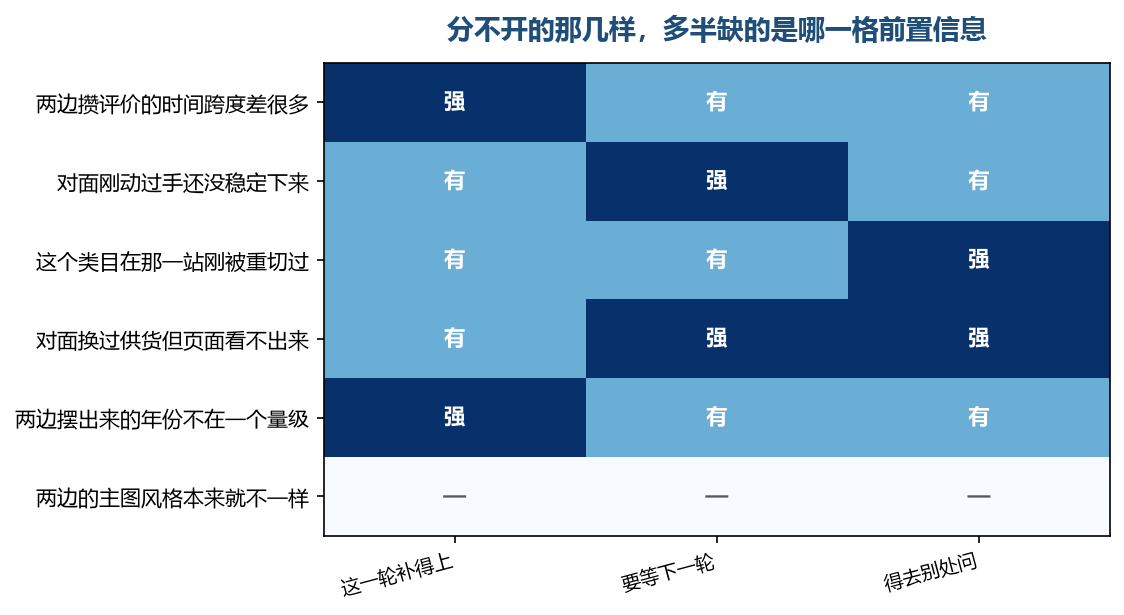
这一堆东西就这么几类,它们分不开多半不是你没看懂,是缺了一格前置的信息
第四步要做的是把那些分不进任何一堆的东西单独标出来,并且不动它们。标的意思是给它们一个地方放着,让它们不掺进前面那三堆里。这一堆东西通常不多,但它们的信息量往往比前三堆加起来还大。
为什么不能顺手解释掉。因为解释需要一个标准,而标准属于另外一句问。这一步如果开始解释,你就会用当下的直觉替标准,最后标出来的东西不是看不懂的,而是你能说得通的那几样,剩下真正看不懂的那些反而被藏进了前三堆里。
停在哪算这一步做完。标志是那些对不上的东西有地方放,并且没有掺进前面三堆。检查的办法很简单,回头看前三堆,里面每一处是不是都能用第一步定的项说清楚。有一处说不清,它就属于第四堆,应该被挪过去。
这一步要花的是什么。它花的是判断,而且是最费判断的一步,因为它要求你忍住不下结论。前两步的判断是选什么、框哪一段,这一步的判断是决定哪些先不判断。忍住这个动作比做动作难,花的力气也更多。
有一类东西几乎每次都会出现在这一堆里,就是两边的数看着对得上、往细里看又对不上的那几处。比如两边的评价数都在同一个量级上,可对面的评价是最近半个月攒起来的,你这一边是攒了大半年才到这一步。这种不对上属于结构上的不对上,塞进前三堆读不出东西,放在旁边反而清楚。
另一类是对面最近才动过的那些地方。它今天是这样,两周前可能不是。这类东西的最大特点是它还没稳定下来,你现在读它读到的可能只是一个过渡状态。放进第四堆,等下一轮再看,通常比当场下判断更靠得住。
如果把第四步挪到前面,最先坏在结论上。你先给结论,再回来标那些看不懂的东西,这时候你标的标准已经变成了哪几样支持我的结论。支持的那几样会被你说清楚,不支持的那几样会被你归到别的地方去,标出来的东西恰好是错的那些。
还有一种坏法是第四步被整段省掉。省掉之后你手上是干净的三堆,看着很整齐。可三堆太整齐本身就是个信号,真实的对照很少这么整齐。太整齐通常意味着你把不顺的那一部分藏起来了,而它们并不会因为你不看就消失。
第四堆在下一轮里的用处最大。这一轮你看不懂的那几处,往往是因为你缺了一个前置的信息,比如不知道对面换了供货,或者不知道这个类目在你这个站上刚刚被重新切过。下一轮你补上了这个信息,这一堆里的东西会自己掉进前三堆。
标记的方式可以用最省事的做法,在那一处旁边画一个记号,或者单独抄到纸的另一块地方。不用给它分类,也不用给它排序。这一步只要让它不被忘掉、也不被掺进前三堆,任务就算完成。
第四堆还有一个实际的处理节奏,就是不要当场给它下定义。你可以把它留着,等下一轮走完再回头看,两轮一对比,有些当时看不懂的东西会自己显出形状。急着在一轮之内把它解释清楚,往往解释出来的是错的,而错的解释比不解释更麻烦。
走完第四步之后,这一轮就结束了。你手上应该有一张按项分的表、一张标着窗口的日期行、三堆有名字的东西,以及一堆单独放在旁边的东西。这四样凑齐,这一轮该做的动作就都做完了,接下来是读它,那是另外一句问的事。
有一个可以自查的地方,就是回头看第四堆里有没有混进本来属于前三堆的东西。混进来的话,说明你分堆的时候手松了。松的原因通常是这几处看着不重要,就随手挪到旁边去。不重要的东西也有它该在的位置,位置错了,下一轮你就找不到它。
顺序打乱会白做哪些功
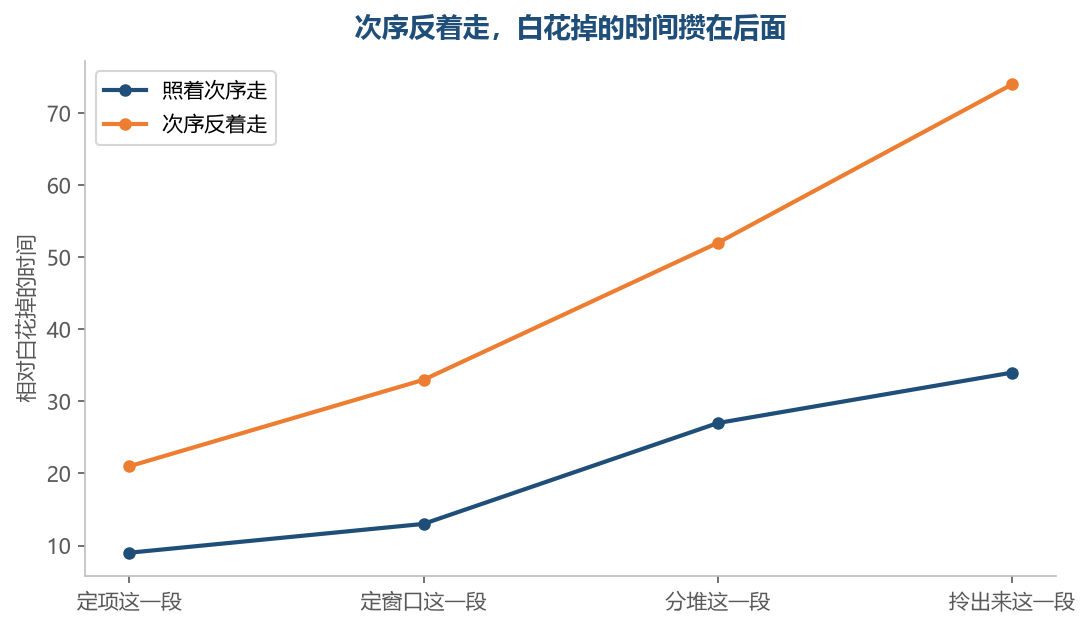
次序反着走的那种开头还高一些,往后就追不上,白花掉的时间是攒在后面的
把次序打乱,白做的功是可以一笔一笔数出来的。最典型的一种是前面说的先翻页面再定项,白掉的是翻页面的那段时间。你翻了两个小时,定完项之后发现其中大部分内容跟你定下的两项没关系,那部分时间就是白花的。
第二种白做是先分了堆再定窗口。白掉的是分堆那一次的全部工作量,因为窗口一改,堆就散了。分堆是这四步里最费手上动作的一步,它一白做,浪费的时间通常比第一步多。这也是为什么顺序里窗口要排在分堆前面。
第三种白做是先给结论再标第四堆。这种情况下白掉的不是某一段工作量,而是整段对照的可信度。你标出来的东西是按支持结论挑的,前面的三堆也是按这个方向归的,整张表看起来完整,实际上一处都不能用来核对。
第四种白做是把项在一轮之内改掉。改项看起来只是改了一行字,实际作废的是已经看到的全部。项是列的坐标,坐标一换,表里每一行都要重新看,而且你在旧坐标下形成的印象还会留在脑子里干扰你。
这四种白做有一个共同点,都是发生在很靠前的位置,代价却落在后面。前面十分钟草率一下,后面两天都在还。这个不对称关系说明次序这件事的价值不在做得快,在做得准,一开始那一两步值得反复确认再往下走。
还有一种不太容易被当成白做的情况,就是把该串起来的两步做成了并行。你一边定项一边填数,看着效率高。实际上你填的那些数里,有一部分是在项还没定死的时候填的,等项定下来,这一部分要么删掉,要么留着但心里不踏实。
并行还有一个隐蔽的代价,就是你会记住错的因果。你会以为某两处差别是同一件事造成的,因为它们是在同一段时间里被看到的。这个印象一旦形成,后面很难修正,因为它没有对应的记录可以核对。
要不要干脆不写次序、凭感觉走。凭感觉走的人第一次未必比按次序走的差,因为他对自己的活儿熟。差别在换场景的时候显出来,换了类目、换了站,凭感觉的人要重新摸索,按次序的人只要把项和窗口换掉就能接着走。
次序被打乱之后还有一种后遗症,就是你会对整件事失去判断。因为你不知道哪一段出了问题,只能全盘重来。按次序走的人出了问题能定位到是哪一步,改那一步就行,不用把四步一起推倒。
还有一种是次序没乱、但每一步都只做了一半。第一步写了项但没写死,第二步写了日期但没核对对面,第三步分了堆但留了悬空,第四步标了东西但掺回了前三堆。这种半成品看起来四步都走了,实际上每一环的产出都接不上下一环,最后的表谁也读不动。
次序这件事的收益是攒出来的,不是当天就能看见的。你按次序走了一遍,当下只是拿到四样东西;走到第三遍、第四遍的时候,你会发现自己在第一步的判断变快了,因为前面几遍的返工都发生在这一步之前。
有一句话可以拿来当场自查:我现在做的这一步,依赖前面哪一步的产出。答得出来,说明次序没乱;答不出来,说明你在做的那一步前面是空的,它产出的东西接不上任何地方,多半要重做。
这四步里被跳过最多的是第二步。因为它最轻,只是一行日期,看起来可做可不做。而被跳过之后问题暴露得最晚,往往到分堆那一步才发现。跳一次之后你以为学过教训了,下次还是会跳,因为那一行日期实在不像一道工序。
被跳过第二多的是第四步。因为它不带产出,只是把几样东西放到旁边。人都有一种把桌面清空的冲动,看不懂的东西放在那里会让人不舒服,于是顺手解释掉或者顺手删掉。解释掉和删掉,代价都在下一轮才显现。
如果把四步的顺序整个倒过来走,会发生什么。你会先看到最难解释的那几处,因为它们最显眼;然后你会围着它们造一个解释;接着你会去找支持这个解释的项;最后你才把窗口定下来。这一条路走完得到的结论,跟着你一开始的那一眼走。
倒着走的人通常不觉得自己倒着走,因为每一步单独看都说得通。分辨的办法还是那一句自查:这一步依赖前面哪一步。倒着走的人回答这一句的时候,会指向后面那一步,这是次序反了最直接的特征。
每一步停在哪算这一段做完
四步各自有一个停点,停点清楚,你就不会在一步里耗太久,也不会带着没做完的东西往下走。停点写下来的好处是它可核对,你不用凭感觉判断自己做完没有,看一眼那几个标志就行。
第一步的停点是一句话。这句话里含两项,一项是你这一款,一项是对面那一款,中间是一个可比的项目,句子里没有并且两个字。念得出来、听得懂,第一步就算做完。念不出来,说明项还没定住,别往下走。
第二步的停点是一行日期。这一行要出现在记录的最上面,并且两边的日期范围是一致的,长度也一样。对完这一行,看一眼两边的日期是不是同一天取的,是就可以往下走,不是就先补上取数那一天。
第三步的停点是每一处都有归属。你把看到的东西过一遍,每一处都能说出它属于哪一堆。说不出来的那一处,先记下来,不要硬塞。全部能归属,或者不能归属的都已经记下来了,第三步就算做完。
第四步的停点是那些对不上的东西都有了地方放。检查的方式是回头看前三堆,里面每一处都能用第一步定下的项说清楚。有一处说不清,它就该被挪到第四堆。挪完之后前三堆是干净的,第四步就算做完。
停点这件事还有一层作用,就是它把做没做完这件模糊的判断变成了看得见的一行字。你把停点写在每一步后面,做完一步就划掉一行,一天下来你清楚自己走到了哪儿,不用凭疲惫感来判断进度。
四步走完之后还有一个总的停点,就是回头看第一步那两行字还在不在。项和窗口在这一轮里有没有被动过。没动过,说明这一轮是干净的,可以拿去读;动过,说明中途改了口径,前面几步得重新走一遍。
把停点写下来的另一个用处,是它能把一件模糊的事变成一件能交接的事。你把这张表交给同事,他不用问你做到哪儿了,看那几行就知道。这一点在两个人一起做同一件事的时候特别省事。
停点设得太靠后是另一种常见的毛病。比如把第一步的停点设成把所有的项都想清楚,那你可能一整天都停不下来,而后面三步一直在等。停点应该设在这一步的产出够不够下一步用,而不是设在你想不想得明白。
反过来,停点设得太靠前也不行。第一步只写一个项目名就往下走,走到第三步你会发现根本分不开堆,因为可比的项太少。够不够用是停点的唯一标准,这个标准在设的时候就能对出来,不用等走完才知道。
有一种情况是走完四步之后你想回头改第一步。这种回头通常有两种原因,一种是项真的定错了,一种是你在第四堆里看到了一些东西动摇了自己。前一种该回头,后一种不该,因为第四堆本来就是留给你先不判断的地方。
这一步跟前面几步的产出一脉相承。每一步的产出都是下一步的输入:项是窗口的输入,窗口是分堆的输入,分堆是标记的输入。这条链条上任何一环空着,后面那一环就接不上。判断自己有没有走完,看的就是这一环有没有接上。
整条路子走完,你手上应该留下这么几样:一句写着两项的话,一行日期,三堆有名字的对照,以及一堆单独放在旁边的东西。这几样都不是结论,它们只是把这件事整理成可以读的样子,读是后面那句问的事。
最后说一句关于熟练的话。第一次走这四步你可能要花半天,走顺了之后它会变成一套你顺手就做的动作。到了那一步,你不再需要把四步写在纸上,因为次序已经长在手上。但换了一个新的类目或者一个没做过的站,还是建议重新写一遍。